 Continuation 是什么?简而言之,就是代码执行状态,利用它可以把当前的执行状态保存起来,以供以后调用。Scheme 应当是最早支持完整的 Continuation 的语言了,事实上从理论上来说,任何支持 Closure 的语言都能手工实现 Continuation ,不过许多语言还是提供了现成的 Continuation 的支持,例如 Ruby 就有一个类似于 Scheme 的
call/cc(call-with-current-continuation) 的函数 callcc (因为“/”在 Ruby 里面不能作为变量名,所以最多只能做到这么像了 ;) )用于支持 Continuation 。
说了半天,到底 Continuation 是个什么东西?它能用来干什么?事实上如果限制到词法作用域之内,goto 也可以算作一个简化版的 Continuation 。一个更高级一点的例子是 setjmp/longjmp 或者是大多数人更熟悉的“异常(Exception)”都可以算作“只出不进”的 Continuation 。而真正意义上的 Continuation 比它们都有趣得多。下面让我们通过一个例子来发现它的神秘之处。
在开始讨论 Continuation 的特性之前,让我先来看看我们所熟悉的东西。实现一个二叉搜索树,我想这是任何一个自称会写程序的人都应该能随手写出来的东西了(本文中的代码使用 Ruby 语言,如果你不会 Ruby 语言也没有关系,不去关心语法细节的话,Ruby 代码也可以当作伪码来看。)
class Tree
  attr_reader :left, :right, :value
def initialize(val)
    @value = val
    @left = @right = nil
  end
def insert(val)
    if val < @value
      if @left.nil?
        @left = Tree.new(val)
      else
        @left.insert(val)
      end
    elsif val > @value
      if @right.nil?
        @right = Tree.new(val)
      else
        @right.insert(val)
      end
    end
  end
end
执行以下操作
tree = Tree.new(10)
[15, 11, 7, 9, 3, 2].each { |i| tree.insert(i) }
就可以得到如下图所示的二叉树:

关于二叉树,有三种经典的遍历方法:前序遍历、中序遍历和后序遍历,都是非常简洁经典的代码:
class Tree
  def inorder_travel(&brk)
    left.inorder_travel(&brk) unless left.nil?
    brk.call(value)
    right.inorder_travel(&brk) unless right.nil?
  end
  def preorder_travel(&brk)
    brk.call(value)
    left.preorder_travel(&brk) unless left.nil?
    right.preorder_travel(&brk) unless right.nil?
  end
  def postorder_travel(&brk)
    left.postorder_travel(&brk) unless left.nil?
    right.postorder_travel(&brk) unless right.nil?
    brk.call(value)
  end
end
然后就可以直接遍历了,例如,下面是中序遍历的结果:
tree.inorder_travel do |i|
  puts i
end
# Output =>
2
3
7
9
10
11
15
到目前为止,我们轻松实现了二叉搜索树以及其三种遍历方式,不过这是通过传递函数(Block)而被被动调用的遍历方式。熟悉 C++ 的人应该都知道 STL 以及它里面的 iterator :它为所有的容器提供了一个通用的遍历接口,更重要的是,它使用一种主动调用的方式,你通过 iterator 按需取值,这种特性特别是在不需要遍历所有的元素的时候特别有用。例如,考虑比较两颗树是否有同样的元素(而不考虑树的结构)的代码:
  def same_fringe?(t1, t2)
    i1 = t1.iterator(:inorder)
    i2 = t2.iterator(:inorder)
until i1.value.nil? and i2.value.nil?
      return false if i1.value != i2.value
      i1.inc
      i2.inc
    end
    return true
  end
用传统的被动迭代的方式的话,通常会这样做:
  def same_fringe?(t1, t2)
    seq1 = Array.new
    t1.inorder_travel { |i| seq1 << i }
    seq2 = Array.new
    t2.inorder_travel { |i| seq2 << i }
until seq1.first.nil? and seq2.first.nil?
      return false if seq1.first != seq2.first
      seq1.shift
      seq2.shift
    end
    return true
  end
但是如果是一颗很大的树,并且从前面几个节点开始就能判断出不相等的话,用传统迭代的方法一下子把它们全部展开会造成许多不必要的浪费。可是,iterator 虽然用起来很好用,但是实现起来却不是那么容易了,首先看一个中序遍历的 iterator 的实现:
module Iterator
  class InorderIterator
    def initialize(tree)
      @stack = Array.new
      until tree.left.nil?
        @stack.push tree
        tree = tree.left
      end
      @tree = tree
    end
def value
      if @tree.nil?
        nil
      else
        @tree.value
      end
    end
def inc
      if @tree.right.nil?
        @tree = @stack.pop
      else
        @tree = @tree.right
        until @tree.left.nil?
          @stack.push @tree
          @tree = @tree.left
        end
      end
    end
  end
def iterator(method)
    if method == :inorder
      return InorderIterator.new(self)
    else
      raise NotImplementedError("Only inorder iterator supported.")
    end
  end
end
仍然是中序遍历,原来三行的代码现在增加了 N 倍,而且结构也更加复杂了,还增加了一个栈的开销(当然如果我们的树有指向父节点的指针的话,可以不用这个栈),原因出在哪里呢?
就中序遍历来说,思想是非常简单的,先遍历左子树,然后访问自己,再遍历又子树,在支持递归函数调用的语言(现在应该几乎是找不到不支持递归调用的语言了吧?)中可以很简洁明了地表示出来,这就是我们前面写的 inorder_travel 的那种方式。系统会在递归调用之前把当前的执行环境压入栈中,以保证调用完成之后可以从栈里弹出原来的执行环境继续执行,好像根本没有发生过跳转一样。
另一方面,如果是使用 iterator 方式,使用者调用 iterator 取得 value 之前,需要将自己的执行状态压入栈中,然后跳转到 iterator 的函数那里,以便取得 value 之后能够回到原来的地方继续执行。
矛盾就出在这里:系统(编程语言)提供的保存函数执行环境的方法是将其压入栈中,然而程序的栈只有一个,如果要让 iterator 主动调用方式来占用栈,于是在二叉树那边就只能放弃递归方式(在我们上面的例子中是手工模拟出了一个栈);如果想要遍历的时候直接使用递归,那就只能使用被动调用的方式,调用者现在变成被调用者,屈身于二叉树遍历的代码所占有的栈上。
如何解决呢?如果能把执行环境保存在其他地方(而不是栈上),就不会出现只有一个栈无法共享的情况了。扯了这么一大堆,终于要轮到今天的主角 Continuation 出场了!还记得本文开头对 Continuation 的描述吗?它就代表着一个函数的执行状态,这是什么意思呢?简单地说,现在你像持有一个普通对象一样持有一个执行环境,你可以把它保存到任何地方(不再被限制到栈上),并随时再进入到那个执行环境中继续先前中断的执行过程。
废话就别说了,先来看用了 Continuation 之后情况会变成怎么样:
module ContinuationIterator
  include ContinuationIteratorImpl
def iterator(method)
    return create_iterator("#{method}_travel")
  end
end
原来花 40 行的代码实现了一个 InorderIterator ,这里只要 7 行代码就可以支持包括前序、中序和后续遍历的三种遍历方式。当然这里我没有把 ContinuationIteratorImpl 的代码算进来,那是因为它是一个可高度复用的模块。不止限于当前的三种遍历方式,甚至不限于二叉树!任何对象,你都可以用它的某个遍历函数来制造一个 iterator !例如,我们用 Ruby 内置的 Array 的 each 遍历方法(就是按顺序遍历)来制造一个 iterator :
array = [5, 7, 11, 3, 0, 9]
array.extend(ContinuationIteratorImpl)
iter = array.create_iterator(:each)
就这么简单!现在生活就美好了!按照被动调用的经典的套路来写遍历方法,然后利用 ContinuationIteratorImpl (得考虑给它取一个更短一点的名字了! :D )就可以造出一个 iterator 来,让调用者以主动调用的方式来使用。一切都完美了!这一切都是 Continuation 的功劳!我们用 Continuation 在两边各自作了一个代理,提供了栈之外的保存执行环境的空间。如果你兴趣正浓的话,就跟我一起来看看这个 ContinuationIteratorImpl 到底是如何实现的吧!
代码如下所示,其中 Iterator 类只是一个包装,主要的工作集中在 create_iterator 上,代码并不长,但是并不容易看懂:
module ContinuationIteratorImpl
  class Iterator
    attr_reader :value
def initialize(&brk)
      @generator = brk
      @value = @generator.call
    end
def inc
      @value = @generator.call
    end
  end
def create_iterator(travel_method)
    caller = nil
    travel = lambda do
      self.send(travel_method) do |val|
        callcc do |cont|
          travel = cont
          caller.call(val)
        end
      end
      callcc { |cont| travel = cont }
      caller.call(nil)
    end
Iterator.new do
      callcc do |cont|
        caller = cont
        travel.call
      end
    end
  end
end
再回到文章的开头吧:Ruby 通过 callcc 来支持 Continuation 。callcc 应该是来源于 Scheme 的 call/cc ,在 Scheme 里这就是函数 call-with-current-continuation 的一个别名。
callcc 会调用一个 block (也就相当于一个匿名函数了,如果你不熟悉 Ruby 的语法的话),并给这个 block 传递一个参数,这个参数就是 Current Continuation 了!好了!有了当前的 Continuation ,也就是当前的执行环境,就可以胡作非为啦!只要把这个东西保存起来,将来就可以随时恢复到“当前”状态了!下面来看一个简单的例子:
def func
  puts "before"
  callcc { |k| $k = k }
  puts "after"
end
执行函数 func 会按照第 2 行和第 4 行的代码打印出 before 和 after ,我们要关注的是第 3 行,这里调用了 callcc ,callcc 把当前的执行状态作为参数传递给作为它参数的那个 block ,也就是参数 k 。这个 block 用 k 做了什么呢?只有一件事情:把它保存到了全局变量 $k 里面!
接下来,任何时候只要执行 $k.call ,就可以恢复 $k 中保存的函数执行状态,从那个地方继续执行。在上面的例子中,每次调用 $k.call 都会打印出 after 来。
callcc 在那里充当了一个 placeholder 的角色,在 Continuation 被 call 的时候就会从那个 placeholder 那里开始继续执行。更有趣的是这个 placeholder 可以被当作一个值来看待,只要给 Continuation 的 call 函数传递参数,这个参数就会作为值出现在那个 placeholder 的地方。看下面的例子:
def func(i)
  sum = i + callcc { |k| $k = k; 5 }
  puts sum
end
调用 func(10) ,会打印出 15 ,因为 callcc 做的事情就是把 Continuation 保存到全局变量 $k 中,然后返回 5 。之后的事情就比较有趣了:试试调用 $k.call(6) 、$k.call(10) ,分别会打印出 16 和 20 出来!
好了,基本只是准备完成了,再回到我们的 iterator 的问题上来,也许画个图能帮助我们理解:
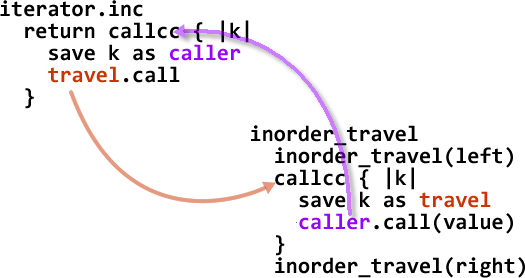
一条线是我们拿到一个 iterator ,对它进行操作,我们把这条线称作 caller 线 ,当调用 iterator 的 inc 想取得下一个值时,inc 做了什么呢?它悄悄地把 caller 线中断掉,并将执行状态保存到变量 caller 中,然后直接跳转进入到另一条线中。
另一条线是中序遍历的线:每当遍历到一个值的时候,它将自己的当前状态保存到 travel 变量中,然后直接跳转到 caller 线中。跳转是通过以当前遍历的值为参数调用 caller 的 call 方法得到的,于是,在 caller 线中,return 那里将返回的是“当前遍历的值”。
图中画的实现需要 travel 线的协作来调用 callcc ,而在我们的实现中实际上 travel 线也是不必知道 Continuation 的存在的,实际上它是调用了传递给它的那个 block ,而那个 block 代理它调用了 callcc ,中间一个东西在两条线之间充当代理,悄悄地调用 callcc 在两条线之间来回跳转,这就是我们的 ContinuationIteratorImpl 了!
如果你还没有晕的话,跟着我一起回到真正的代码上吧!我把代码分成小的片段再贴一遍,首先是创建 iterator 的代码:
    Iterator.new do
      # ...
当调用 create_iterator(:inorder_travel) 的时候发生了什么?在第 28 行,一个新的 Iterator 被构造出来并作为了返回值。构造的时候传递了一个 block ,Iterator 在构造函数中将这个 block 存储在变量 @generator 中:
    def initialize(&brk)
      @generator = brk
      # ...
每次调用 @generator 的 call 方法就可以得到下一个值,那么 @generator 这个 block 做的事情只是把当前执行环境保存起来,然后去调用 travel 。
      callcc do |cont|
        caller = cont
        travel.call
      end
再来看看 travel 是什么。最开始它是一个函数(使用 lambda 构造):
    travel = lambda do
      self.send(travel_method) do |val|
        # ...
这个函数会调用对应的 travel_method ,例如 inorder_travel 。像 inorder_travel 这样的遍历函数会接受一个 block 作为参数,并会把遍历到的值作为参数去调用这个 block 。看看这里传递进去的 block 都做了些什么事情?
        callcc do |cont|
          travel = cont
          caller.call(val)
        end
它将当前执行状态(这个时候正在 travel 线中)保存到 travel 变量中,然后通过 caller 变量里保存的 Continuation 跳回到 caller 线中,并将要“返回”的值传递过去。注意此时 travel 变量里面保存的是一个 Continuation ,幸好在 Ruby 里一个 Continuation 和一个 lambda 函数(确切地说,应该叫做一个 Proc 实例)都可以通过 call 方法来调用,如果你觉得这样不太好,也可以用一个简单的 lambda 包装一下:
travel = lambda { cont.call }
总之现在 travel 中保存的是 travel 线中中遍历的状态,并且正好在遍历了一个元素的地方停下来了。下次再调用 iterator 的 inc 方法的时候,又会调用一次 @generator :
    def inc
      @value = @generator.call
    end
再重复前面的步骤,不过这次 travel 已经不是最初的那个 lambda 函数了,而是 travel 线中刚好遍历了一个元素之后中断掉的那个 Continuation !call 之,直接跳入 travel 线继续执行,拿到下一个值之后,再通过 caller 跳转回 caller 线!多么完美啊!
最后,当 travel 线执行完退出之后,如果 caller 线还要继续调用的话,我们只是简单地返回 nil 给它:
      callcc { |cont| travel = cont }
      caller.call(nil)
好了,到此为止,希望我的讲解帮助你理解了 Continuation ,而不是让你变得更晕了 ;) 。本文的完整源代码和相关的单元测试可以从这里下载,Enjoy!
Comments (32)
well, i don't deep *callcc* issue a lot. And some questions may be useful to you:
1. many people know about the CPS transformation, and callcc as a means to get hold of the implicit continuation ("the rest of the computation"), but we often have a hard time using continuations: there's a large gap between understanding code which uses callcc and the ability to actually synthesize a solution to a problem using callcc. We lose easy-understanding in using callcc, what we get? If we get a lot, how?
2. When should we adopt callcc and how can we express callcc idea using pencil and paper easily.
Just my 2 cents.
/Jack
Thanks for your question, I'll try to answer them in my next post.
当时是为了实现read-time thread scheduler进行的实验,在C/C++里面用非常晦涩的方式做一个部分的实现,不过,真正意义上 Continuation 还是只能在lisp之类“神奇”的语言上找到哇~~
当时石老师还帮了我不少:-)
To shawn
你用call/cc 写一个goto :) 我的理解是call/cc比goto强大的是它还有返回值
setjmp/longjmp也可以代“返回值”,不过也只算callcc的简化了。C/C++用setjmp/longjmp实现一部分,但是不能实现完整语义上的Continuation。
setjmp/longjmp 虽然能够做跳转,但是它并不保存栈的内容,就是说如果不小心的话,你本想保存起来的栈会被后面的执行过程覆盖掉,所以 setjmp/longjmp 一般是在不到万不得已的时候不推荐使用,或者要小心使用。而真正意义上的 Continuation 实现会保证帮你把那个执行环境保存下来,不被释放或者覆盖掉。
我想要实现 Continuation 至少需要两个东西: 1. Closure 用于获取当前执行环境(以及相关的一些需要保留的东西)。 2. GC 或者类似的东西,用于保证将执行环境保留下来,不被随意覆盖或者释放掉,并且在不用的时候又需要保证被正确释放。
完整的语义,厄其实我也说不清楚,可以理解成为进程/线程的上下文环境切换;
setjmp/longjmp两个操作隐含了一个意思:所有的跳转,只能往一个方向跳,这事实上是异常处理中堆栈回滚的语境,只要能保证跳转的方向,是没有问题的。
但是continuation中,跳转的方向是不定的,往前跳,也要往后跳。 所以用setjmp/longjmp实现continuation的时候,要在使用前切换堆栈,事实上就完整模拟了线程/进程切换的机制
pluskid&shawn:
一个问题,使用continuation是不是更容易有stack overflow的exception?
我曾经设计过全栈保存的coThread,稍微改动一下应该可以实现你的这个要求。C++做continuation也是可以的,改天我来搞一个。
关于jack说的两个条件,我的想法是Closure和GC是没必要的
因为栈都被我保存下来了,而堆和全局区本来就是持久的。当然是否堆和全局区需要和外界保持一致性我不清楚。
是这样的啊?不过你做的那个实现是可以重入的吗?如果不行的话,大概是 Continuation 的一个特殊情况,就是我在后一篇中提到的 Fiber 。Fiber 可以胜任 Continuation 的大部分应用,而且模型也更简单一些。我目前还没想到 Continuation 比 Fiber 强的那些特性到底能真实应用在什么地方。
你的inorder_travel是要专门为cont写一个吗?
也就是说,那个cont是侵入式的?
shifan said: 你的inorder_travel是要专门为cont写一个吗? 也就是说,那个cont是侵入式的?
是的,就我文章中实现的这个的话是“侵入式”的,但实际上并不是那么暴力,它还是按照原来的套路,传递一个函数(block)进去,只是在这个函数中把 travel 的执行给悄悄中断掉了它自己不知道而已。当然,实际上语法上是很灵活的,不管是不是做成侵入式的,都是很容易的。
Yes, I know coroutine. And I know there's
Fiber::Corefor it. But I thought coroutine is just two Fibers -- except for the syntax: coroutine looks like peer-to-peer while Fiber looks more like master-and-slave. Correct me if I was wrong. :)虽然名义上这样说,但是估计用 Closure 来手工模拟的话,可能需要使用 Continuation passing style (CPS) 的方式来写程序了。
No, closure is a function plus its environment, while a continuation is a state where you can continue running of your program there, something like a suspended thread. But unlike thread, you can re-entrance from there (the continuation) for infinity times.